Пользователь загружает фотографию документа и ждёт ответ. На первый взгляд нужен ИИ, который «понимает картинки». Но иногда полезная информация — только текст, а изображение служит способом его передать.
Разделить извлечение и анализ
В GlossCheck реализованы загрузка фотографий и документов, OCR и анализ пользовательского запроса. Для проверки такого маршрута я разделяю качество извлечения и качество итогового ответа: удачная формулировка не исправляет неверно распознанную цифру.
Если вопрос зависит от расположения элементов, графика или визуального состояния объекта, одного текста может быть недостаточно. Выбор инструмента определяется содержанием задачи, а не наличием модной модели.
Сначала определить, какой результат нужен от файла
Документ может участвовать в разных задачах: найти в нём номер, перенести значения в карточку, проверить комплектность или понять изображённую схему. Один входной формат не делает эти задачи одинаковыми. Если результат зависит только от текста, полезно отдельно получить текст и проверить его. Если важны взаимное расположение, отметки на плане или состояние предмета на фотографии, текстовый слой может не содержать достаточного основания.
Сформулируйте результат как наблюдаемое действие. Например: сотрудник получает черновик карточки с номером документа, датой и перечнем позиций, затем проверяет значимые значения. Это точнее пожелания «ИИ должен прочитать файл». В такой постановке понятно, какие поля обязательны, где допустима пустота и какая ошибка остановит дальнейшую передачу. Извлечение и смысловая проверка получают самостоятельные критерии.
| Задача | Возможный первый маршрут | Что проверять | Когда одного текста недостаточно |
|---|---|---|---|
| Найти номер и дату | Извлечь доступный текст или применить OCR | Символы, порядок и связь с названием поля | Значение определяется положением в сложной форме |
| Перенести строки таблицы | Извлечь структуру и проверить столбцы | Соответствие количества, цены и наименования | Таблица распалась на несвязанные строки |
| Сравнить формулировки | Получить проверенный текст двух версий | Полноту и сохранность существенных оговорок | Смысл выражен графическими пометками |
| Проверить схему | Рассмотреть изображение в контексте задачи | Подписи, связи и ограничения интерпретации | Текст не передаёт расположение объектов |
| Оценить читаемость | Проверить качество входного изображения | Размытость, обрезку и доступность важных зон | Нужная часть отсутствует на снимке |
| Подготовить карточку | Извлечь сведения и проверить правила полей | Основание каждого значения и обязательность | Недостающие сведения приходится предполагать |
Маршрут не обязан быть одинаковым для всех файлов. В цифровом PDF может существовать пригодный текстовый слой; фотография потребует распознавания; схема — отдельного визуального разбора. Условия выбора должны быть видимы и проверяемы. Нельзя без оценки качества считать один формат гарантией одного способа обработки или автоматически использовать самый сложный инструмент для любого вложения.
Рабочий процесс пилота обработки документов
Вход: разрешённые типы файлов, набор характерных примеров и описание требуемого результата. Роли: владелец процесса задаёт значимые поля, специалист по документам проверяет эталоны, разработчик строит маршрут, пользователь принимает черновик. Выход: пригодные сведения с основанием либо объяснимый возврат на уточнение. Проверка: отдельно оценены извлечение и последующее применение.
Первый шаг — отбор примеров. Соберите не только лучшие сканы, но и обычные затруднения: наклон, тень, несколько страниц, разные колонки, рукописную пометку и обрезанный край. Укажите, насколько каждый тип характерен для работы. Один редкий экстремальный пример не должен определять всю архитектуру, но отсутствие частого неудобного формата делает пилот необъективным. Для проверки можно подготовить безопасные учебные документы с такими же свойствами.
Второй шаг — разметка ожидаемых сведений. Эксперт отмечает правильные значения, их положение и случаи, где источник не даёт ответа. Пустое значение не всегда ошибка системы: на документе оно тоже может отсутствовать. Поэтому эталон различает пропуск распознавания и реальную неполноту. Если эксперты не могут прочитать важную цифру, нельзя требовать от автоматики достоверного угадывания.
Рабочий сценарий
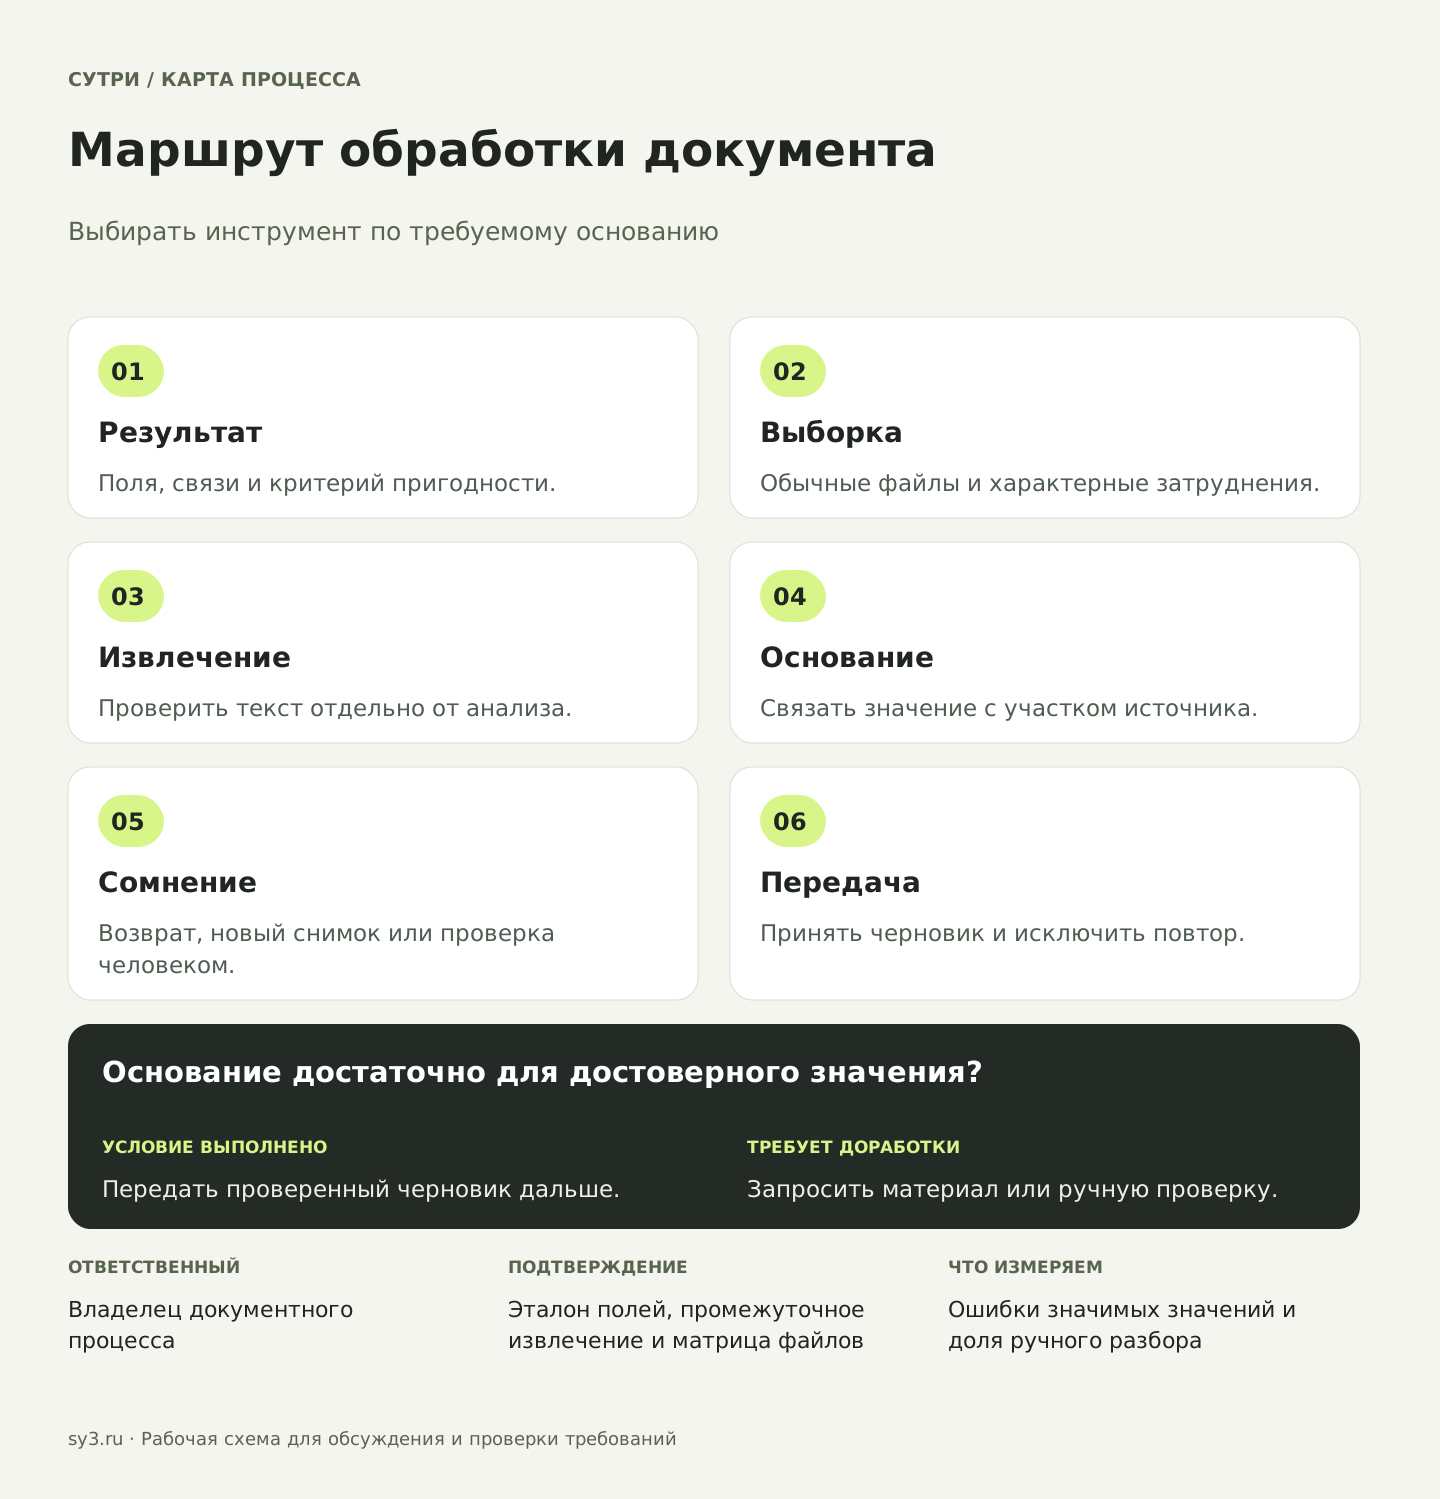
Маршрут обработки документа
Выбирать инструмент по требуемому основанию
01
Результат
Поля, связи и критерий пригодности.
02
Выборка
Обычные файлы и характерные затруднения.
03
Извлечение
Проверить текст отдельно от анализа.
04
Основание
Связать значение с участком источника.
05
Сомнение
Возврат, новый снимок или проверка человеком.
06
Передача
Принять черновик и исключить повтор.
Основание достаточно для достоверного значения?
Условие выполнено: Передать проверенный черновик дальше.
Условие не выполнено: Запросить материал или ручную проверку.
Ответственный
Владелец документного процесса
Подтверждение
Эталон полей, промежуточное извлечение и матрица файлов
Что измеряем
Ошибки значимых значений и доля ручного разбора
Третий шаг — сравнение маршрутов. Для текстовой задачи испытайте извлечение и OCR; для визуально зависимой — подходящий анализ изображения. Одинаковые документы проходят одинаковые критерии результата. Сохраняйте исходный файл, промежуточное представление и итог в пределах согласованного хранения. Так видно, на каком переходе исчезло условие или перепуталась строка.
Четвёртый шаг — смысловая проверка. Убедитесь, что номер попал в поле номера, дата относится к нужному событию, а строка таблицы не собрана из значений соседних позиций. Модель способна оформить неверное извлечение очень убедительно. Поэтому красивый структурированный результат не является доказательством правильности. Для существенных значений полезно показывать фрагмент основания рядом с черновиком.
Пятый шаг — обработка сомнения. Если значение не читается, система обозначает проблему и предлагает конкретное действие: новый снимок, ручную проверку или уточнение поля. Повторная обработка того же нечитабельного участка не должна бесконечно расходовать ресурсы. Правило остановки зависит от задачи и качества входа, а не только от числа неудачных вызовов.
Шестой шаг — проверка передачи в рабочий процесс. Принятые сведения связываются с объектом и сохраняют происхождение. Автоматическое заполнение черновика и окончательное утверждение имеют разные состояния. Если далее создаётся документ или запись в системе, проверяют повтор, исправление и отказ. Пилот не завершён, пока полезный результат нельзя отличить от просто полученного ответа.
Качество изображения и границы предварительной обработки
В официальном руководстве Tesseract рассматриваются причины ухудшения распознавания, включая особенности изображения, ориентацию и разметку страницы. Это основание проверять подготовку входа отдельно от языкового анализа. Однако конкретные настройки должны подбираться на ваших документах; один удачный фильтр не гарантирует исправление любых сканов.
Предварительная обработка тоже может ухудшить материал. Агрессивное удаление шума способно стереть тонкую цифру или значимую отметку. Поворот может исправить наклон, но не восстановит обрезанный край. Поэтому сохраняйте возможность сопоставить преобразованный вариант с исходным. Если нельзя объяснить, почему обработка улучшила нужные поля, не стоит оценивать её только по более аккуратному внешнему виду страницы.
Для пользователя часто полезнее правильная подсказка при загрузке, чем дополнительные повторные попытки. Покажите, что в кадр должны попасть края документа, важные строки и читаемые значения. Но не перекладывайте всю ответственность на человека: система должна заметить явно непригодный вход и не объявлять результат надёжным. Предупреждение имеет смысл, когда указывает исправимое условие, а не просто сообщает низкое качество.
Учебный разбор таблицы поставки
Предположим, нужно перенести позиции из документа в черновик заказа. В одной колонке указано количество, в другой единица измерения, в третьей цена. OCR распознал все символы, но объединил строки в неправильном порядке. Проверка по доле распознанных букв покажет хороший результат, хотя итоговая карточка станет неверной. Здесь важна структура связи значений, а не только текстовая точность.
Для такого документа эталон содержит позиции целиком. Проверяющий сопоставляет наименование, количество, единицу и цену в одной строке. Если одна строка переносится на две визуальные линии, это отдельный пример. Система не должна создавать вторую позицию только из-за переноса на странице. При невозможности уверенно восстановить связь строк маршрут возвращает таблицу на просмотр, сохраняя уже извлечённые данные как черновик.
Затем проверяют повторный файл и исправленную версию. Один и тот же документ не должен незаметно создать второй заказ, а исправление не должно переписать ранее утверждённый результат без следа. Эти условия лежат за пределами самого OCR, но определяют качество автоматизации. Поэтому решение о выборе инструмента принимается в составе полного процесса, включая подтверждение и дальнейшее использование.
Матрица приёмки извлечения
| Проверочный файл | Ожидаемое поведение | Что сравнивается с эталоном | Причина ручной проверки |
|---|---|---|---|
| Чёткий одностраничный скан | Извлечение значимых полей | Значения и их назначение | Несовпадение обязательного поля |
| Фотография под углом | Корректная обработка либо понятный возврат | Доступность всех нужных участков | Искажённая или обрезанная строка |
| Две колонки текста | Сохранён смысловой порядок | Связь заголовков и абзацев | Перемешанные условия |
| Таблица с переносами | Позиции не раздвоены | Полный состав строки | Неоднозначная связь значений |
| Отсутствующее значение | Нет выдуманной подстановки | Пустота и причина | Значение обязательно для действия |
| Плохо читаемая цифра | Сомнение видно до передачи | Сопоставление с исходным участком | Нельзя подтвердить существенный параметр |
| Повторный документ | Соблюдено правило повторной обработки | Объект и версия результата | Возможно дублирование операции |
Отдельно проверяйте итоговый анализ на уже правильном извлечённом тексте. Если ошибка остаётся, её причина не в распознавании. Возможно, инструкция анализа не учитывает исключение или формат результата теряет часть смысла. Такое разделение позволяет исправлять конкретный переход и не менять все компоненты одновременно. Сравнение «весь конвейер хорош или плох» слишком грубо для полезного улучшения.
Как оценивать затраты без обещаний экономии
Расход включает подготовку файла, извлечение, анализ, контроль и повторы. Для тяжёлого документа отдельный шаг может доминировать по времени, а для короткого — ручная проверка. Соберите данные по типам файлов и исходам: принят автоматически, проверен человеком, возвращён пользователю. Только после этого можно сопоставлять варианты по стоимости пригодного результата. Дешёвый ответ на неполный текст не является более выгодной обработкой.
Не исключайте неудачные попытки из расчёта. Они используют ресурсы и время сотрудников. При этом расход пилота не следует автоматически умножать на будущую нагрузку без учёта состава документов. Пользователи могут начать загружать новые форматы или более длинные пакеты. Сохранённая модель входов и ограничений позволяет пересчитать прогноз и объяснить изменение условий.
После пилота остаются перечень поддерживаемых документов, критерии качества, правила остановки и контрольный набор. Этот комплект полезнее универсального заявления «умеем работать с любыми файлами». Он показывает, где текстового извлечения достаточно, где необходим визуальный контекст и в какой точке требуется решение человека. Так инструмент подбирается под проверяемую задачу бизнеса, а граница автоматизации остаётся понятной.
Контрпример: все цифры прочитаны, результат неверен
В условном документе рядом стоят дата составления и дата поставки. OCR правильно распознал обе, но анализ записал первую в поле срока поставки. Повторное распознавание не исправит эту ошибку: потеряна связь значения с назначением поля. Проверьте тот же анализ на вручную подготовленном правильном тексте с сохранёнными подписями.
Если ошибка остаётся, уточняйте правила анализа и представление контекста. Если исчезает — исследуйте промежуточное извлечение. Сохраните два независимых результата проверки в пределах принятого хранения. Это позволяет выбрать следующее изменение по причине, а не просто заменить модель на более дорогую.
Документация и источники
Посмотреть работу в деталях
Покажите разрешённые примеры файлов и назовите поля или выводы, которые нужны сотруднику. Я разделю извлечение и анализ, подготовлю контрольный набор и определю случаи ручной проверки. Направления автоматизации. Написать в Telegram · Написать в MAX
Короткие ответы
Вопросы по теме
Когда достаточно OCR?
Когда нужные сведения представлены текстом и не требуют интерпретации визуальных отношений.
Почему правильные цифры не гарантируют правильную таблицу?
Значения могут попасть не в те строки или столбцы, изменив смысл результата.
Как сравнить затраты двух способов?
На одном контрольном наборе учесть обработку, повторы и ручную проверку приемлемого результата.